凤鸣 GEO 诊断方法白皮书
一、总体架构:双判据诊断
凤鸣 GEO 对品牌官网的 AI 可引性诊断采用双判据结构:
- 主分 · 官网 AI 可引性分(PY8-100):衡量官网内容「能否被 AI 理解、信任并引用」,满分 100,八维加权。与凤鸣 GEO 小程序端同源引擎、同源参数,同一站点两端分数一致。
- 子判据 · 技术准入门禁(T8):衡量官网「AI 爬虫能否正常进入」,8 项技术检查。门禁不通过时,AI 无法获取内容,内容层优化无从谈起。
PY8-100 与 T8 各自独立计分、互不换算。报告同时呈现两项,避免「技术满分但内容不可引」或「内容优质但 AI 进不了门」的误判。
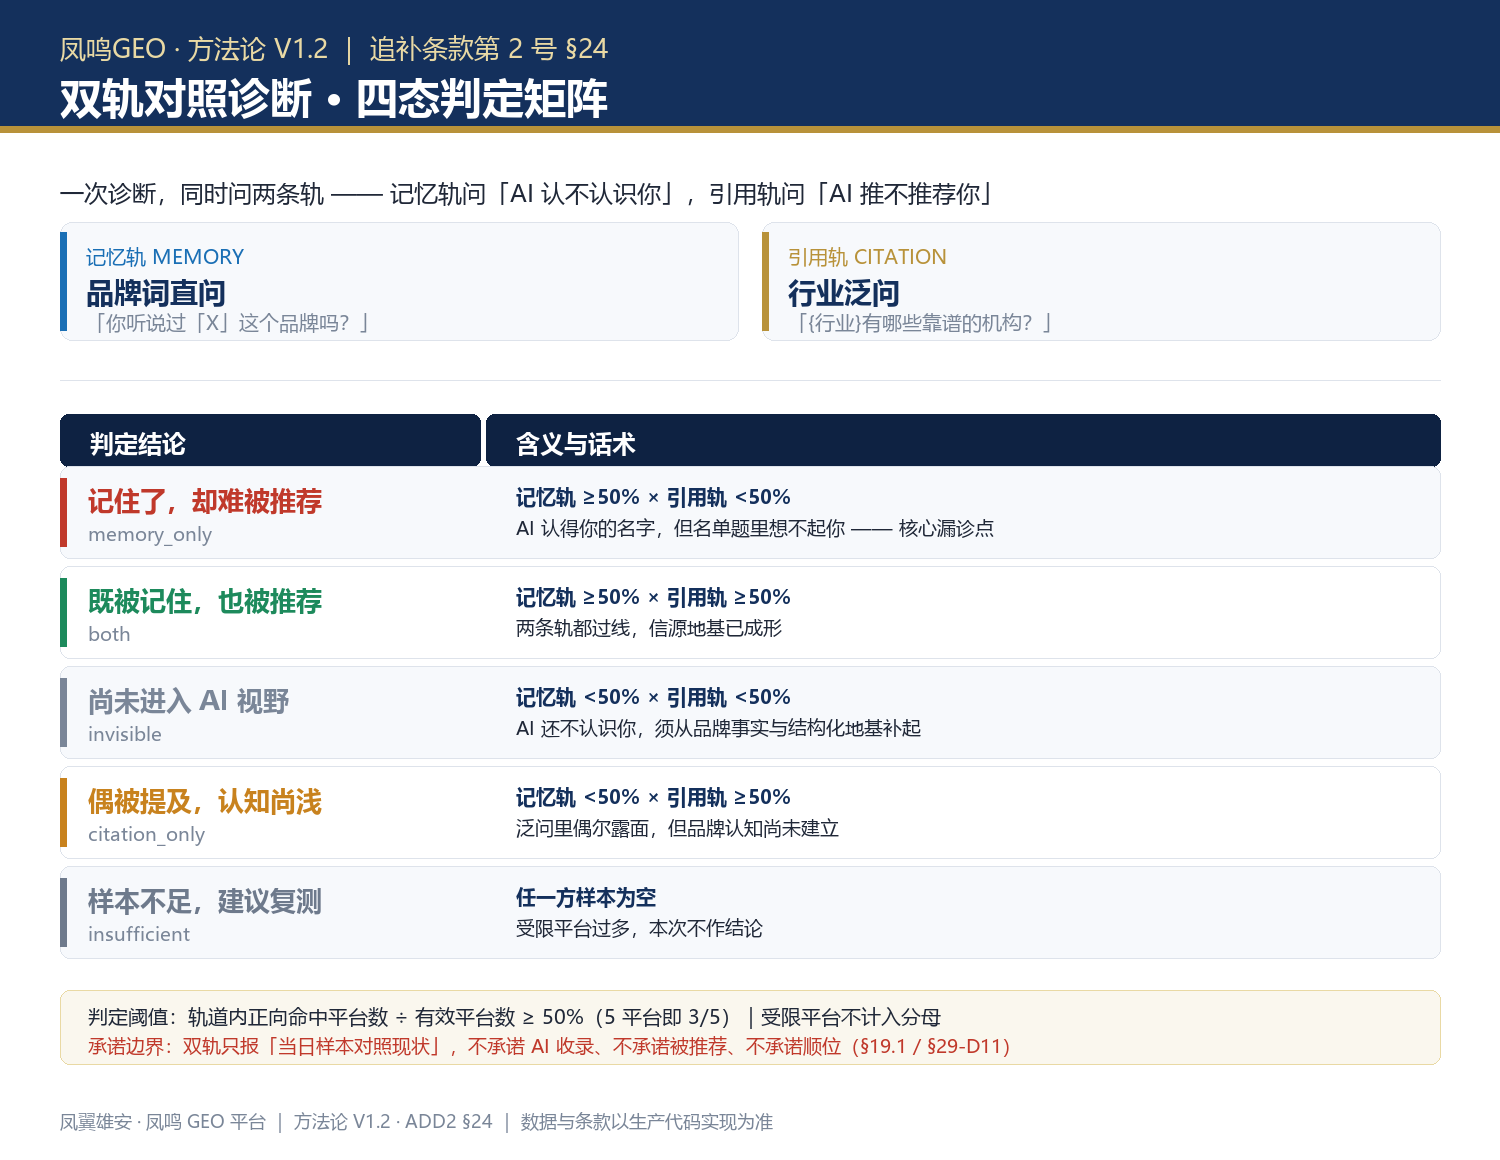
1.1 双轨对照:不止「认不认识」,更看「推不推荐」
在双判据之上,诊断进一步分两条轨道对照:记忆轨直接以品牌词提问(如「你听说过「某品牌」吗」),衡量 AI 是否认识你;引用轨以行业泛问提问(如「做某行业的机构有哪些」),衡量 AI 是否主动推荐你。两轨并置,才能看出「被提及 ≠ 被推荐」的关键落差——品牌词答得准、行业推荐却不出场,是最常见也最致命的漏诊点。两轨结论落为四态:记住了却难被推荐(memory_only)、既被记住也被推荐(both)、尚未进入视野(invisible)、偶被提及认知尚浅(citation_only)。
引用轨的行业口径来源分为三级并如实标注:用户填写(user)> 官网 title/description 推断(inferred)> 通用兜底(fallback)。为避免误导,行业口径来源会在报告中明示。
二、PY8-100 八维评分标准
| 维度 | 满分 | 判定要点 |
|---|---|---|
| llms.txt 配置 | 15 | 根路径是否存在 llms.txt,是否包含站点概览、导航与内容说明,是否放行 AI 爬虫 |
| 结构化数据 JSON-LD | 15 | 四类实体覆盖:Organization / LocalBusiness(Place) / Service / Person,每类 3.75 分;要求语法合法、字段完整 |
| 内容新鲜度 | 15 | 核心页声明 datePublished / 更新时间;90 天内满分,之后线性衰减;未声明为 0 分 |
| SEO Meta 元数据 | 10 | title / description 完整性与长度、OG 标签、canonical 等 |
| 页面结构与语义层级 | 10 | H1 唯一性、标题层级(H1→H2→H3)不跳级、主题单一化 |
| 内链结构 / 孤立页面 | 10 | 站内互链覆盖度,无孤立页;导航与页脚可达性 |
| EEAT 信任信号 | 15 | 主体信息(运营主体/联系方式/备案)、作者与责任主体可溯、信源等级与溯源要素 |
| 内容数据支撑度 | 10 | 可核验实绩、数据引用、外部信源引用(fact marks / sources) |
等级映射
A1 ≥ 85 A2 ≥ 75 B ≥ 60 C < 60
- A1(85–100):内容层对 AI 高度可引,维持性优化即可。
- A2(75–84):整体可引性良好,少数维度有提升空间。
- B(60–74):AI 可理解但引用置信度受限,建议按修复清单逐项优化。
- C(0–59):内容层对 AI 存在明显障碍,优先处理零分维度。
三、T8 技术准入门禁
T8 检查 AI 爬虫进入官网的 8 项技术条件:可达性、HTTPS、robots 协议、sitemap、JSON-LD、OG 标签、语义层级、Meta 元数据。门禁结论为「放行」或「受阻」(附阻断原因),作为内容层诊断的前提判据呈现。
T8 满分仅代表「AI 技术上能进门」,不代表「AI 愿意引用」。对官网的可引性判断,请以 PY8-100 主分为准。
四、AI 平台品牌收录实测方法
4.1 覆盖平台
国内一线 AI 平台逐一直接实测:豆包、腾讯元宝、DeepSeek、Kimi、通义千问(以当次诊断实际可用平台为准,受限平台如实标注)。
4.2 三轮自然语言问询
- 每个平台对同一品牌进行 ≥3 轮语义不同的自然语言问法(品牌认知、主营业务与官网、品牌介绍),降低单次问询的偶然误差。
- 同平台各轮并行发起,平台之间串行,避免相互污染。
4.3 收录判定规则
- 正向句子判定:仅当品牌名或官网域名出现在不含否定语境的句子里,才计一次「提及」。「我不了解某品牌」「没有找到相关资料」等否定句即使包含品牌词也不计提及。
- 多数轮判定:≥3 轮中多数轮出现正向提及,才判定「已收录」,并标注命中轮数(如「已收录(2/3 轮)」);单轮偶然提及不构成收录结论。
4.4 来源标注(透明性)
source:api:平台官方接口实时召回(模型参数化知识),非平台 UI 搜索页快照;该差异向客户明确披露。source:snapshot:本机定时采集快照回退(官方接口暂不可用时)。- 受限(登录墙/限流/接口异常)平台如实标注「本次受限」,不伪造、不补样本。
五、信源主权:从「被提到」到「被采信」
AI 可以在不引用你任何自有内容的情况下,用第三方转述把你说得头头是道。因此凤鸣 GEO 的判断标准不是「AI 有没有提到你」,而是——AI 提到你时,引用的是不是你自己说的事实。这就是「信源主权」(Citation Sovereignty)。
5.1 一个必须公开的自测结果
凤鸣 GEO 对运营主体自有品牌做过真实采集回算:品牌被 AI 提及率接近 100%,而自有信源引用率长期接近 0%,被引用的是知乎专栏、企业信息平台、门户号等第三方来源。我们先把这套方法用在自己身上——这是本方法论的起点,也是我们不做「声量幻觉」生意的原因。
5.2 三项公开指标(并列披露,不报单项)
| 指标 | 定义 | 回答的问题 |
|---|---|---|
owned_cite_rate自有信源控制率 | 被 AI 引用的信源中,属于品牌自有域名的比例 | AI 引用的是不是你自己的事实 |
authoritative_cite_rate权威信源占比 | 被引信源中,属 A/B 级权威源(党政机关、央媒、持证媒体、官方文档、学术库)的比例 | AI 是被谁采信的 |
cite_coverage信源覆盖度 | 能取到结构化信源的回答数 ÷ 总回答数 | 我们看得见多少(采样盲区) |
解释顺序:先看覆盖度,再看权威率,最后看自有率。若覆盖度低于 30%,说明可观测样本过少,此时任何自有率/权威率数字都不具备代表性——凤鸣 GEO 会在报告中如实标注「采样受限」,而不是给出一个好看的百分比。
5.3 判定口径(可复核)
- 自有域判定只按主机名做域名边界匹配,不把标题、锚文本与域名拼接判断——避免「标题里出现品牌词就被认领为自有」的假阳性。
- 权威源三档分档:A 国家级官方/央媒/学术 B 省级党媒/持证媒体/官方文档 C 行业平台/UGC 百科/企业官网(C 级可信但不计入权威)。
- 自有阵地与自有域分列:公众号、视频号等平台托管内容属「自有阵地内容」,计入独立线索指标,不计入自有信源控制率——否则「自有域主权」将失去独立语义。
- 口径版本化:指标口径变更时以新版本号并行记录,不覆盖历史数据,保证趋势可解释、可回溯。
5.4 平台信源能力边界(诚实披露)
| AI 平台 | 结构化信源 | 说明 |
|---|---|---|
| Kimi | ✅ 有 | 联网搜索通道返回真实网页引用 |
| 通义千问 | ✅ 有 | 经官方原生接口开启联网检索后返回 |
| 豆包 / 腾讯元宝 / DeepSeek | ⚠️ 接口侧暂无 | 其开放接口目前不返回结构化信源,须经真实浏览器通道观测;相关数据在报告中如实标注为平台能力边界,不以提示词诱导模型编造出处 |
5.5 提升方法:五个环节
| 环节 | 目标 | 关键动作 |
|---|---|---|
| S1 主权审计 | 先算清账 | 全量被引信源定级 + 三项指标 + 被引域名画像 + 「谁在代表你」结论 |
| S2 自有地基 | 让 AI 抓得到、解得开 | llms.txt(真实纯文本)、sitemap、robots 放行 AI 抓取、JSON-LD 实体、FAQ 问答式结构化 |
| S3 分发矩阵 | 进入高被引载体 | 按平台检索后端匹配内容载体(问答式长文、公众号、云社区、百科词条等),发布台账逐条留痕 |
| S4 阵地对齐 | 自有阵地署名规范 | 公众号/视频号内容署名与实体一致性,回收阵地线索 |
| S5 月度监测 | 看趋势不看单点 | 每日采集 + 三指标仪表盘 + 月度前后对照 |
5.6 承诺边界
我们只承诺过程指标:审计覆盖度、改造项完成率、发布与索引收录、阵地线索、三指标趋势可查。不承诺任何平台的排名、推荐结果或「自有信源率必达某数值」——AI 的采信逻辑不受任何服务商控制,承诺结果本身就是不诚实。
六、提问资产缺口表:五类可查事实
AI 不推荐一个品牌,往往不是「内容不够多」,而是缺了五类可被检索的事实。我们把它拆成一张可逐项核对的「有/缺」表:
| 维度 | 它回答的问题 | 缺口信号 |
|---|---|---|
| 品牌事实 | AI 认不认识你 | 品牌词直问多数平台无稳定认知 |
| 用户场景 | 行业推荐里你在不在名单 | 行业泛问场合不出场 |
| 可信证据 | 被引用时来源是否权威、自有 | 自有域引用占比过低、权威域不足 |
| 承接页面 | 被推荐后能否落到你的页面 | 官网 AI 可引性偏低 |
| 机器可达 | AI 爬虫能不能进门 | robots/防火墙拦截、缺结构化数据 |
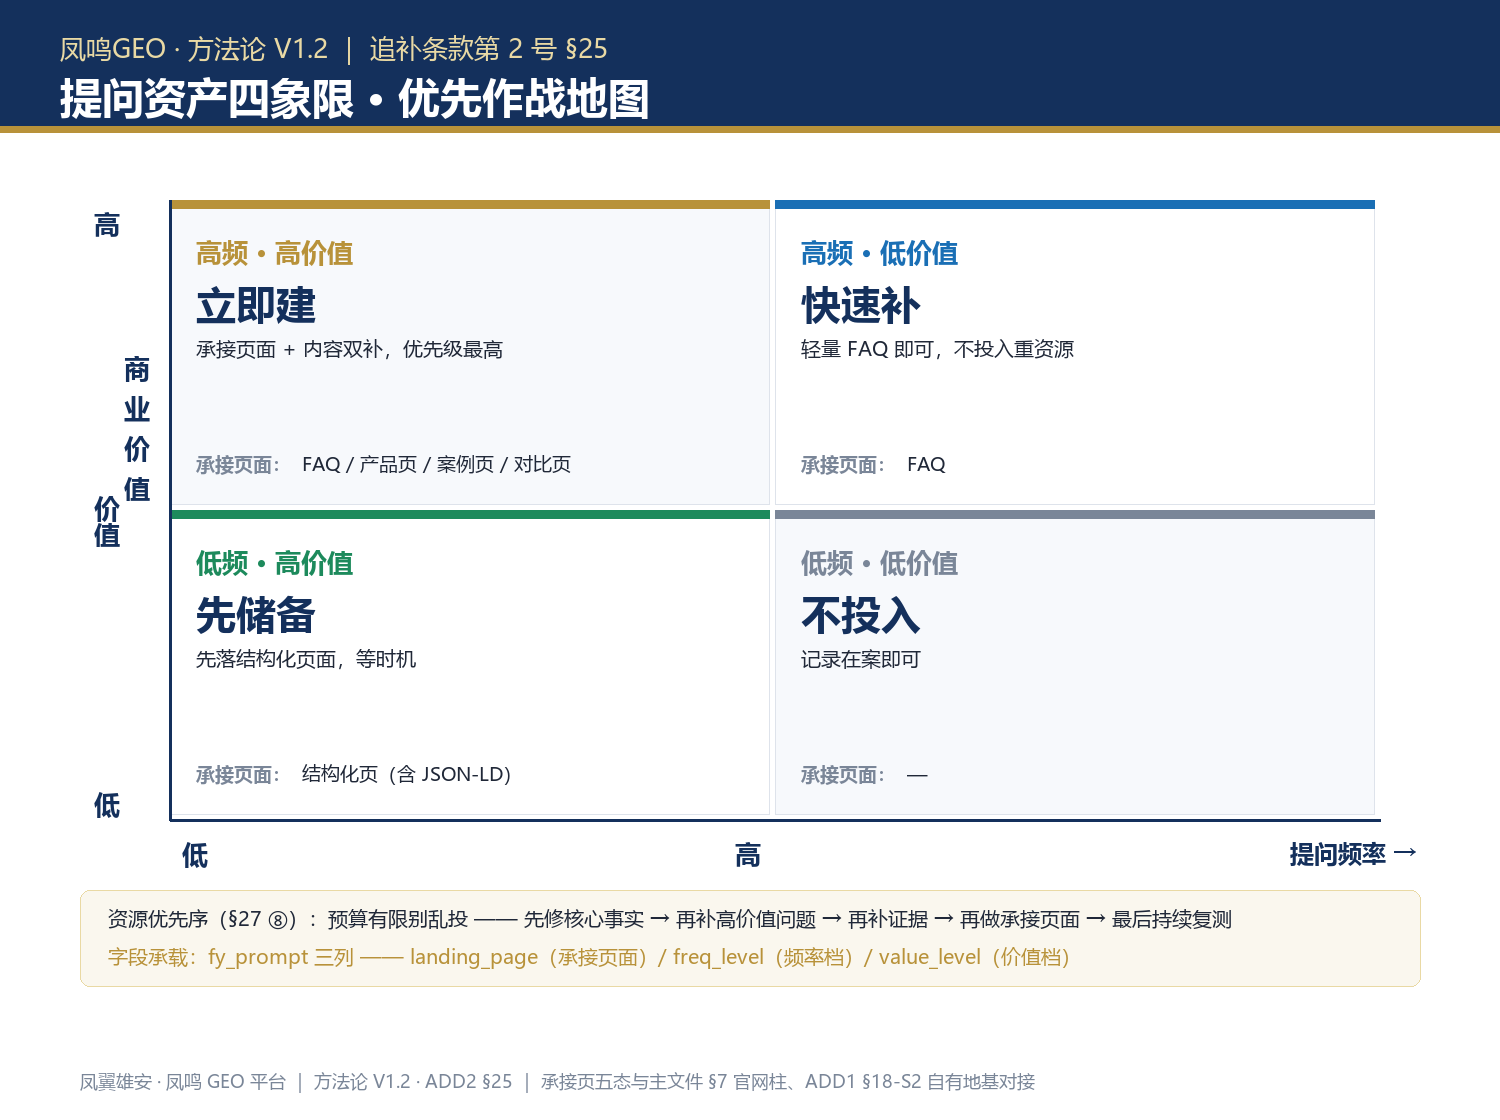
6.1 补齐优先序
先「机器可达」(进不了门,其余全白做)→ 再「承接页面 + 品牌事实」(读得懂、记得住)→ 后「用户场景 + 可信证据」(进推荐名单、被引用时被信任)。本表由既有采集结果聚合而成,不新增数据源;当样本覆盖度低于 30% 时,我们只报覆盖度,不对自有/权威引用率下结论。
七、信源爬升分模型与 SOP 双重实证
7.1 信源爬升分(S1→S5 阶梯)
信源主权不是一步到位,而是一条可分级、可计量的爬升路径(五个环节的完整动作见 §5.5)。这里给出「爬升分」的计量口径:把品牌当前所处的最高已完成阶梯作为基分(S1=1 … S5=5),再按该阶梯内的可核验产出完成率加权,得到 0–5 的连续爬升分。爬升分只反映已完成的改造阶段,不预测 AI 的采信结果。
| 阶梯 | 目标 | 可核验产出(计入爬升分) |
|---|---|---|
| S1 主权审计 | 先算清账 | 全量被引信源定级 + 三指标 + 被引域名画像 |
| S2 自有地基 | 让 AI 抓得到、解得开 | llms.txt / sitemap / robots 放行 / JSON-LD / FAQ 结构化 |
| S3 分发矩阵 | 进入高被引载体 | 按平台检索后端匹配内容载体 + 发布台账逐条留痕 |
| S4 阵地对齐 | 自有阵地署名规范 | 公众号/视频号署名与实体一致性、阵地线索回收 |
| S5 月度监测 | 看趋势不看单点 | 每日采集 + 三指标仪表盘 + 月度前后对照 |
7.2 SOP 双重实证:过程 + 结果
每一项改造动作都要求双重留痕:一为过程实证(动作确已完成、有发布台账与索引收录记录),二为结果实证(改造前后三指标的变化可查)。只有过程有痕迹,不能称有效;只有结果波动、无过程可溯,不能排除偶然。二者同时成立,才计入一次有效改造。我们只承诺过程指标与趋势可查,不承诺任何平台的排名或被推荐结果。
- 零 mock:诊断链路全部真实采集,无任何预置假数据。
- 同源同参:网页端与小程序端使用同一评分引擎与同一爬取参数,同站必同分。
- 单时点样本观察:模型回答随版本、时点与提问措辞波动,收录结果为当次采样观察,建议多次复测看趋势。
- 不作效果承诺:本诊断仅作客观技术观测,不对任何平台的收录或排名作出效果承诺。
九、局限性声明
- 模型参数化知识存在更新滞后,api 召回结果不等同于平台线上搜索/问答的实时表现。
- 爬取受目标站反爬策略与网络环境影响,极端情况下可能以部分页面样本完成评分。
- 评分标准随行业实践演进,大版本升级会在研发版本说明中留痕。